为什么一个答案获得了社区最高赞,却没有被提问者采纳?这个看似普通的问答社区现象,正揭示了个性化问答中最核心的问题:用户需要的并不总是“大家认为最好的答案”,而是最符合自己当前认知状态、问题场景和理解路径的答案。随着个性化成为大模型与智能体研究中的重要方向,已有工作从用户画像、历史记忆等角度,持续提升模型面向不同用户提供差异化服务的能力。然而,一个更基础的问题仍然值得被进一步追问:在问答场景中,究竟什么样的回答才算“个性化”?是更贴合用户当前的知识结构,还是更符合用户正在面对的具体问题场景?是提供更充分的证据来建立信任,还是控制解释复杂度,让用户能够以合适的节奏理解并采纳答案?
围绕这一问题,北京中关村学院联合华东师范大学提出 “CoPA: Benchmarking Personalized Question Answering with Data-Informed Cognitive Factors”,尝试用数据驱动的方法刻画“个性化问答”的内在结构。研究团队没有预先手工规定“什么叫个性化”,而是从海量真实在线问答社区数据中出发,以“用户最终采纳答案”与“社区最高赞答案”之间的分歧为线索,将这种“个体选择与群体共识分歧”(Community-Individual Preference Divergence, CIPD)视为观察用户偏好的自然信号。在此基础上,团队让大模型结合用户历史问答与“采纳答案—高赞答案”的对比,逐条分析用户选择背后的可能原因,再通过多模型归纳、共识筛选与专家验证,将这些分散的选择理由沉淀为六个用于刻画个性化问答的认知因子,包括认知信任、情境锚定、图式一致性、认知负荷管理、元认知支架,以及情感与动机共鸣。通过这些认知因子,论文将“答案是否适合这个用户”转化为可以拆解、解释和比较的评价问题。该工作已被国际计算语言学顶级会议 ACL 2026 接收为 Findings 论文。
论文标题:CoPA: Benchmarking Personalized Question Answering with Data-Informed Cognitive Factors
arXiv地址:https://arxiv.org/abs/2604.14773
代码地址:https://github.com/bjzgcai/CoPA
个性化问题的 CIPD 现象
个性化问答并不是简单地把同一个答案换一种说法。面对同一个问题,不同用户可能期待完全不同的回答:有人需要可执行的代码示例,有人更看重原理图解;有人希望答案直接落到自己的具体场景,有人则需要循序渐进的概念铺垫。
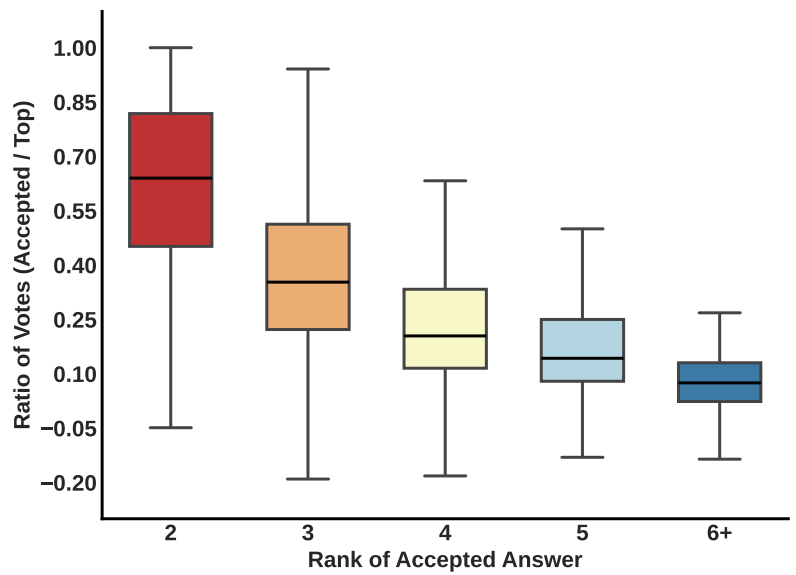
在真实问答社区中,用户的选择并不总是与群体共识一致。一个答案可能获得最多投票,却未必被提问者采纳;另一个答案虽然不一定最受社区欢迎,却可能更符合提问者当下的背景、目标和理解方式。CoPA 将这种“个体选择与群体共识分歧”称为 CIPD,并把它作为观察个性化偏好的关键入口。
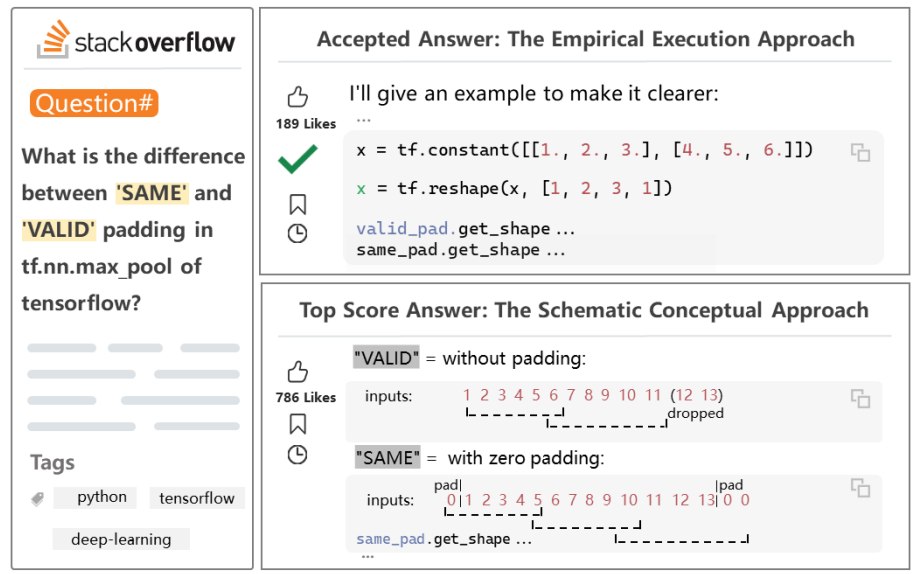
以 StackOverflow 中一个问题为例。社区最高赞答案获得 786 个赞,主要通过图式和概念解释 padding 机制;而提问者最终采纳的答案只有 189 个赞,却直接给出可执行示例和经验验证方式。这个例子说明,用户选择答案时并不只看社区热度,也会受到自身目标、背景知识和问题解决路径的影响。
CIPD 具有跨领域普遍性
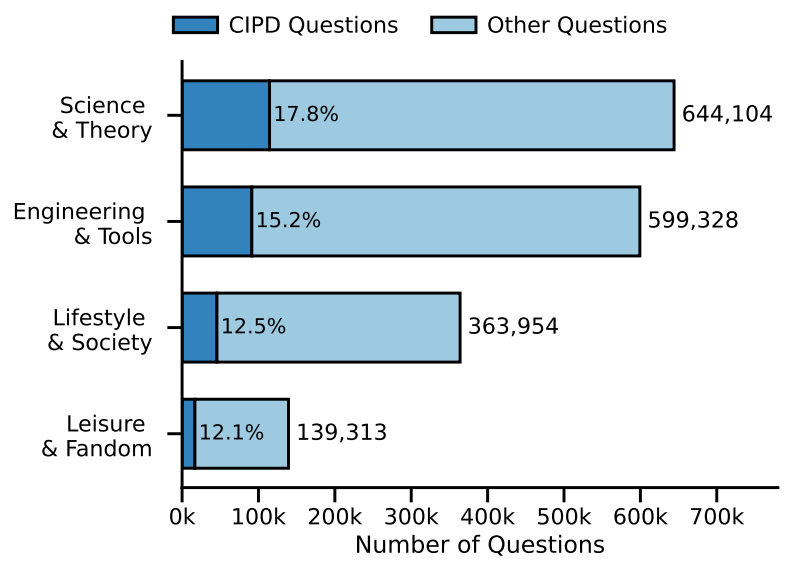
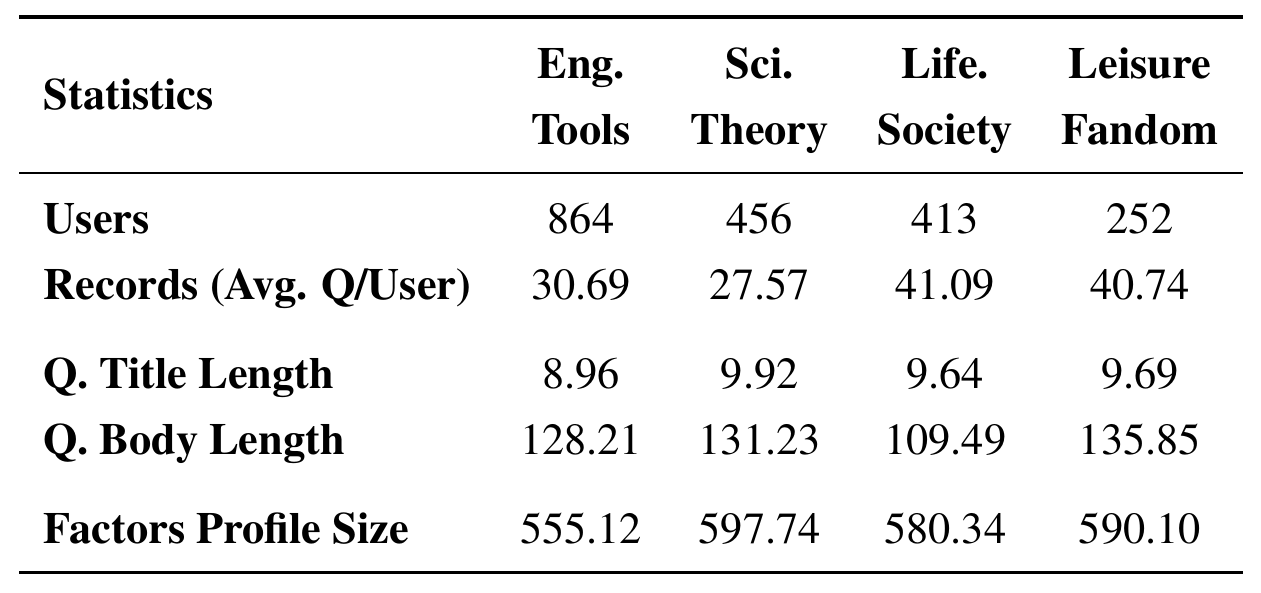
这个 StackOverflow 案例只是 CIPD 的一个具体表现。进一步的统计结果显示,类似的分歧并不局限于单一问题或单一社区,而是广泛存在于问答社区中。在 Engineering & Tools、Science & Theory、Lifestyle & Society、Leisure & Fandom 等不同类型的包含184个领域的问答社区中,都能观察到一定比例的 CIPD 问题。这说明,用户个人选择与社区整体偏好之间的差异具有跨领域普遍性,也为 CoPA 后续从真实交互中提炼认知因子提供了数据基础。
从真实选择中提炼认知因子
针对CIPD现象,研究团队以 StackExchange 多领域问答数据为基础,从约 680 万条问题中筛选 CIPD 样本,构建了覆盖 15,963 名用户、626,786 个问题的分析数据,并进一步归纳出 52,199 条用户选择原因。
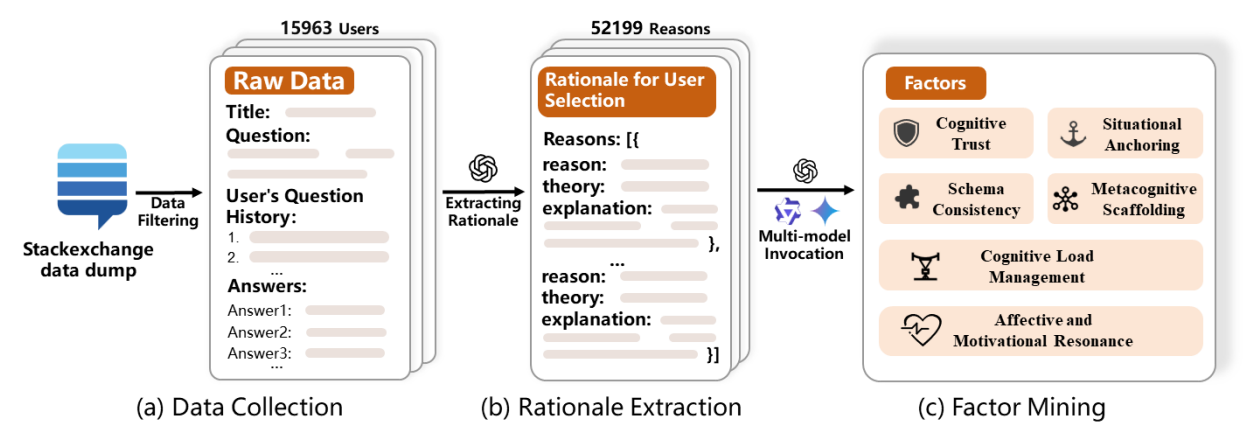
这些选择原因构成了 CoPA 提炼认知因子的基础。基于这些原因,研究团队通过多模型归纳和专家验证,将用户选择背后的原因沉淀为一组核心认知因子,用来刻画用户如何判断一个答案是否可信、是否贴合场景、是否容易理解,具体包括以下六类:
• 认知信任(Cognitive Trust, CT):回答是否满足用户对可信度、可靠性和可验证性的要求。
• 情境锚定(Situational Anchoring, SA):回答是否贴合用户当前问题的具体场景和实际约束。
• 图式一致性(Schema Consistency, SC):回答是否能与用户已有知识结构和理解方式自然衔接。
• 认知负荷管理(Cognitive Load Management, CLM):回答复杂度是否符合用户的信息处理能力和接受节奏。
• 元认知支架(Metacognitive Scaffolding, MS):回答是否提供结构化引导,帮助用户形成更高阶的理解和自我调节。
• 情感与动机共鸣(Affective and Motivational Resonance, AMR):回答是否回应用户当下的情绪状态和动机取向。
通过这六个认知因子,论文将用户对答案的偏好从抽象感受转化为更清晰的认知需求:用户为什么信任一个答案、为什么觉得它贴合自己、为什么愿意采纳它,都可以被进一步拆解和解释。
用认知因子引导个性化回答
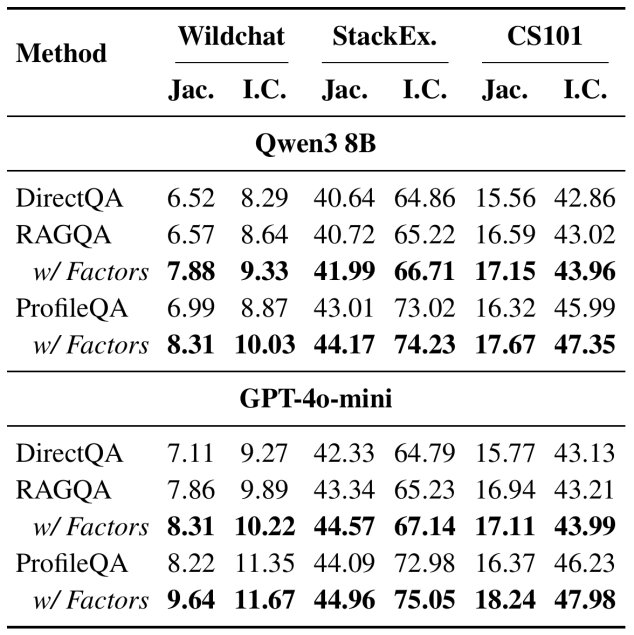
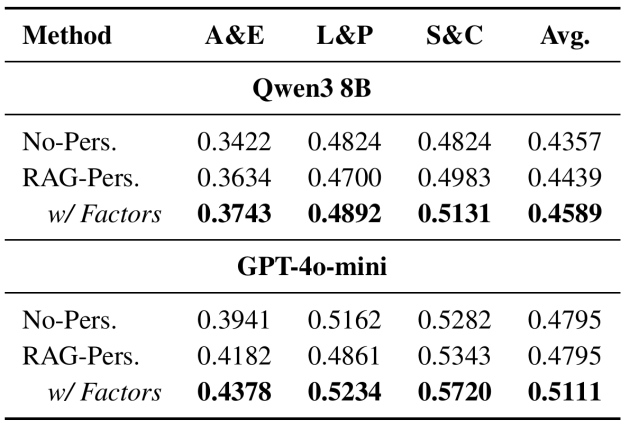
研究团队进一步验证了这些认知因子的可用性。直接将认知因子写入系统提示词中,让模型在回答时显式考虑这些因子。
在这种设置下,即使模型面对的是同一个问题,模型也会调整回答的证据强度、解释方式、细节层次和表达策略,从而更接近用户可能接受和偏好的答案。
实验结果显示,仅将这些认知因子写入提示词,就能提升模型在个性化问答中的表现。
从认知因子到 CoPA Benchmark
基于以上表现,研究团队将这些因子延伸为一套面向个性化问答的评测基准,使其能够在更大规模、更可比较的设置中发挥作用,用于分析回答是否符合用户真实偏好。
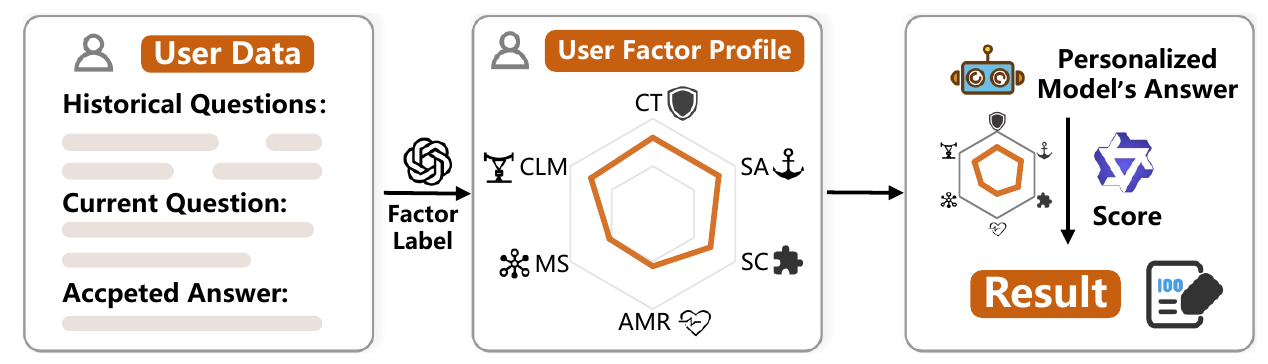
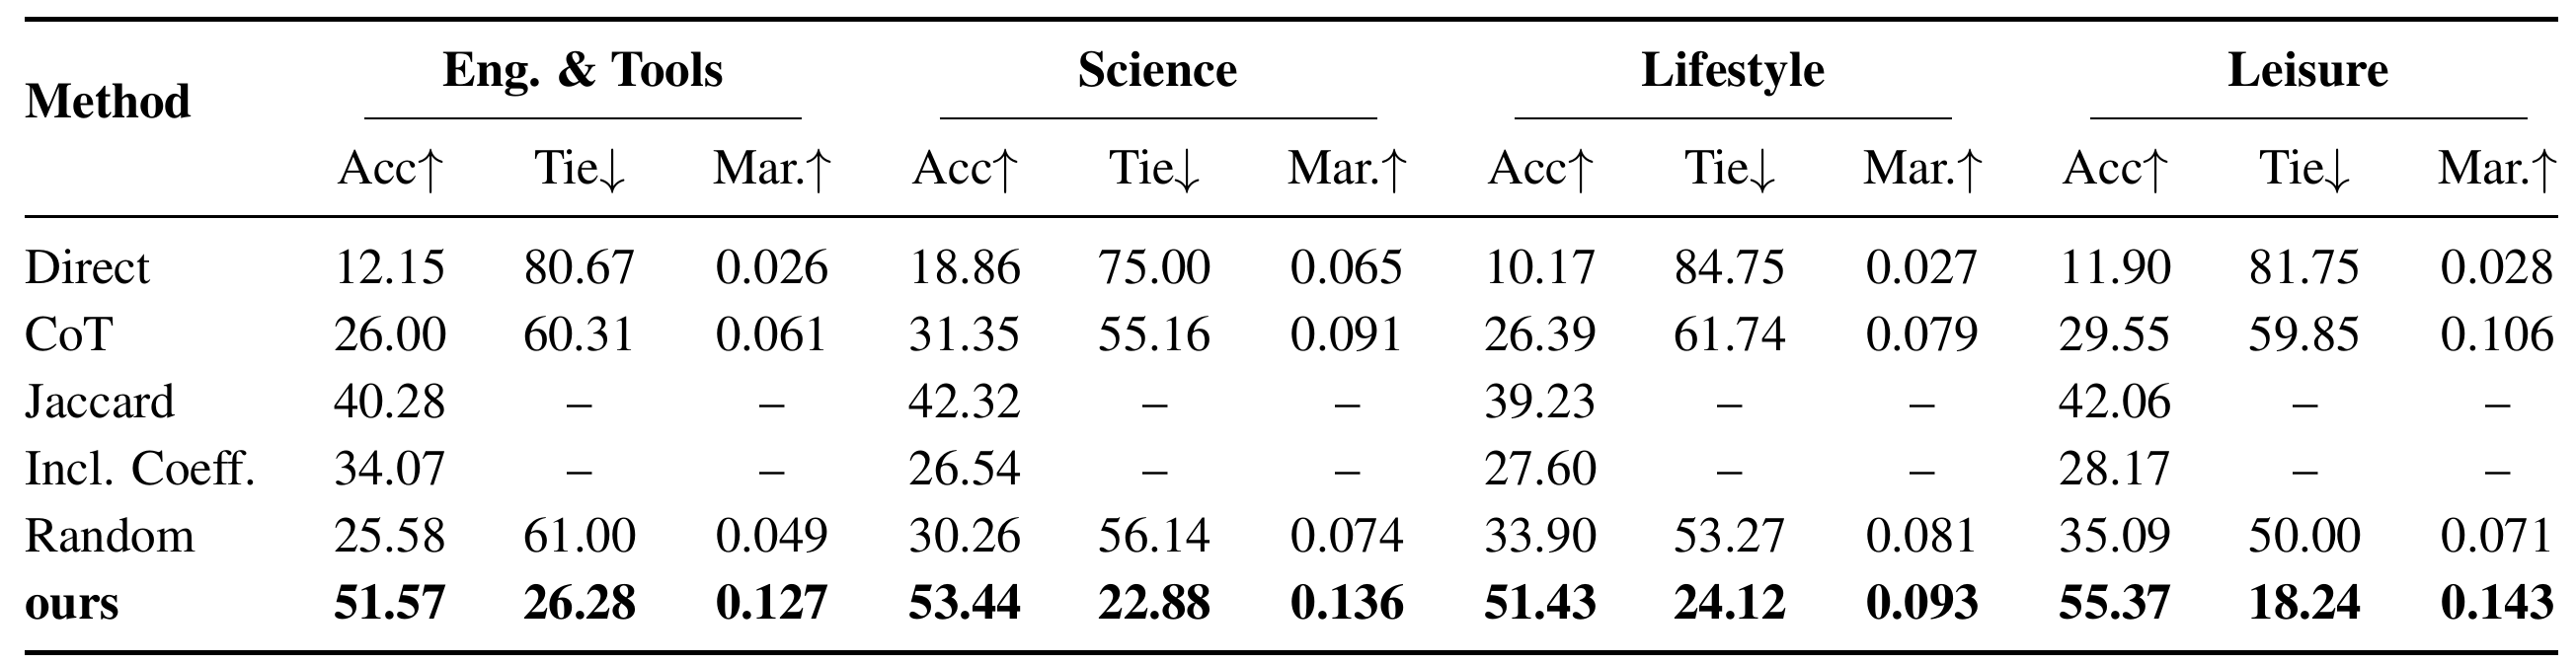
为了验证该测评基准的有效性,团队将“能否区分用户最终采纳的答案和社区最高赞答案”作为实验目标,并与其他评价方法进行比较,考察不同方法能否识别出更贴近用户偏好的回答。论文比较了直接 LLM-as-a-Judge、带思维链的 LLM-as-a-Judge、Jaccard / Inclusion 等启发式指标,以及随机生成因子的评价方式。结果显示,基于 CoPA 认知因子的评价在四类领域中都能更稳定地区分“用户接受答案”和“社区高赞答案”。
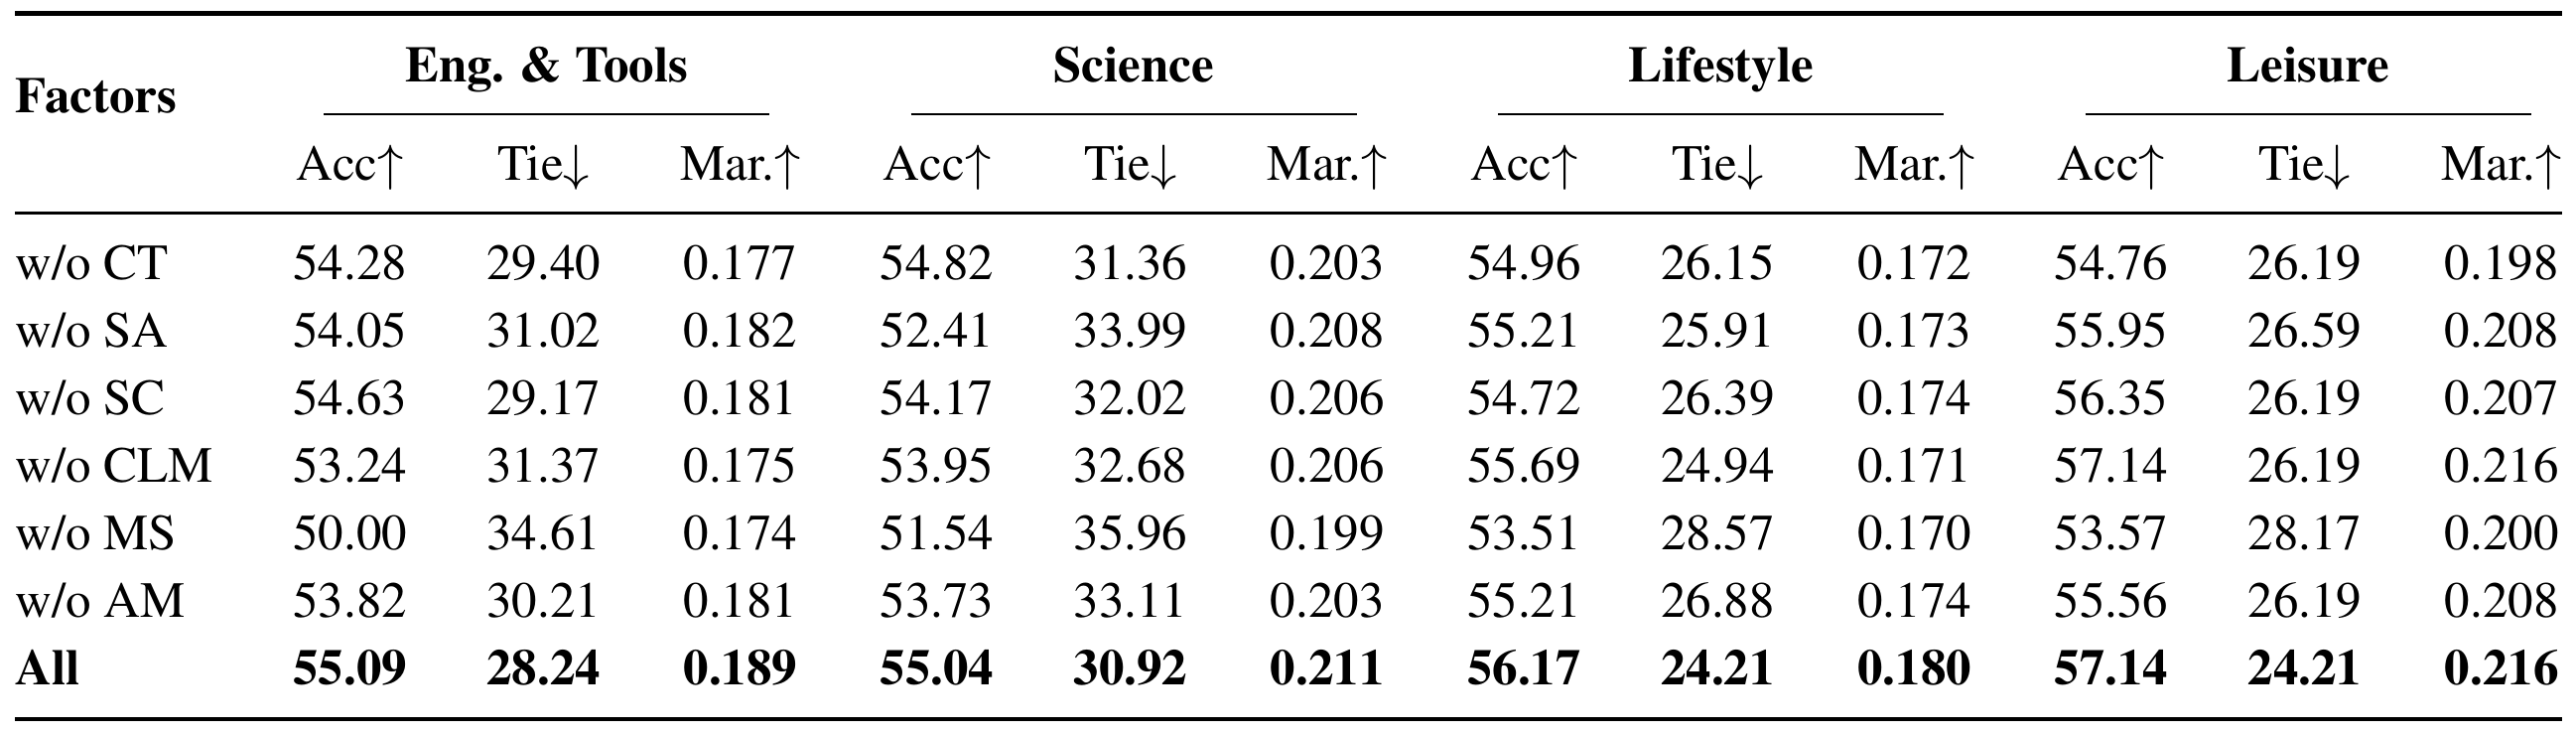
在主实验中,CoPA 因子评价将 Tie Rate 降至 18.24%–26.28%,并将 Accuracy 提升至 51.43%–55.37%。相比之下,直接打分和 CoT 打分常常会因为两个答案质量都较高而给出相同判断,难以捕捉用户真实偏好的细粒度差异。消融实验也表明,去掉任一因子都会带来性能下降,说明这些认知因子各自承担着不同的个性化解释功能。
从“回答正确”到“回答正确且合适”
随着大模型通用能力的不断提升,AI 助手正在进入越来越多人的学习、工作和日常工具链中。人们不再只是期待模型给出正确答案,也希望它能够以自己能够理解、信任和采纳的方式提供帮助。对于未来的个性化模型而言,模型能否理解不同用户、并根据不同用户的喜好去理解完成任务尤为重要。
CoPA 提炼出的认知因子,为这一方向提供了一种观察用户差异的方式。认知因子分别对应了用户在接受答案时可能关注的不同侧面。这些维度提示我们,个性化并不只是表达风格的调整,而是对用户认知过程的更细致理解。
从更长远看,未来的智能体系统需要在事实准确性之外,更好地回应人的认知差异和真实需求。一个高质量的决策,不仅应当是正确的,也应当能够进入具体用户的语境,被理解、被信任,并真正支持其后续判断和行动。沿着这一方向,智能体系统有望从单纯完成任务,进一步走向理解人的需求、支持人的判断,并与人形成更有效的协同。
作者团队及合作单位
本文第一作者为北京中关村学院与华东师范大学联培博士生苏杭,通讯作者为北京中关村学院副教授夏应策、华东师范大学数据科学与工程学院副教授陆雪松和北京中关村学院研究员刘泽群。本项目依托中关村学院培育项目“面向AI原生教育的大模型技术”,研究团队致力于研究在AI原生时代,更适用于教育场景的大模型技术。