近日,北京中关村学院人工智能核心方向团队联合浙江大学、东北大学、英国萨里大学等单位,在大模型高效推理与云边协同方向取得新进展。相关论文《PipeSD: An Efficient Cloud-Edge Collaborative Pipeline Inference Framework with Speculative Decoding》已发布于 arXiv,并被 ICML 2026 收录。
论文提出 PipeSD,一种面向云边协同场景的流水线式推测解码推理框架。PipeSD 将小型草稿模型部署在边缘设备上,将大型目标模型部署在云端,通过“边缘生成、云端验证”的协作方式,充分发挥云端设备计算性能强、边缘设备算力资源闲置且贴近用户的各自优势。在保证输出分布与目标模型一致的前提下,PipeSD 有效降低了端到端推理延迟,并提升了云边整体计算资源利用率。实验显示,PipeSD 在真实云边测试床上,相比现有方法取得 1.16×–2.16× 推理加速,并将云端能耗降低 14.3%–25.3%。
论文链接:https://arxiv.org/abs/2605.13319
代码链接:https://github.com/Ghanyunhe/PipeSD
为什么云边协同适合大模型推理?
随着大语言模型在对话、编程、数学推理等任务中的广泛应用,推理延迟和能耗已经成为限制其落地的重要瓶颈。传统云端推理能够利用强大的算力,但依赖稳定网络连接,也会带来隐私与云端负载压力;纯边缘推理更有利于隐私保护和离线可用,但边缘设备通常算力和显存有限,难以高效运行大模型。
推测解码为云边协同提供了天然结构:一个轻量草稿模型先快速生成多个候选 token,随后大型目标模型一次性验证这些候选 token。如果候选 token 被接受,就可以跳过多次目标模型自回归生成,从而显著减少端到端延迟,并保持与目标模型一致的输出分布。
在云边协同部署中,边缘设备可以承担草稿模型的快速生成任务,云端负责目标模型的非自回归验证。这既利用了边缘端的本地计算能力,又保留了云端大模型的能力上限,是面向未来端侧智能、移动智能体和隐私敏感应用的重要系统路径。
现有方法的两个瓶颈:通信闲置与验证僵硬
尽管云边协同推测解码具有天然优势,但现有框架仍存在两个关键瓶颈。
第一,许多系统采用“先生成、再传输”的顺序模式。边缘端需要先生成完整草稿序列,再一次性传给云端验证。这会造成计算和通信无法充分重叠:边缘端生成时网络空闲,传输时计算又可能空闲,整体资源利用率不高。
第二,云端非自回归验证(NAV)的触发机制不够灵活。固定草稿长度容易忽略不同任务、不同 token 的难度差异;过早验证会浪费推测机会,过晚验证又可能导致大量错误 token 被回滚,反而增加成本。
PipeSD 的核心目标,就是同时解决这两个问题:一方面,让 token 生成和通信形成流水线;另一方面,让云端验证触发更懂得“什么时候该停下来验证”。
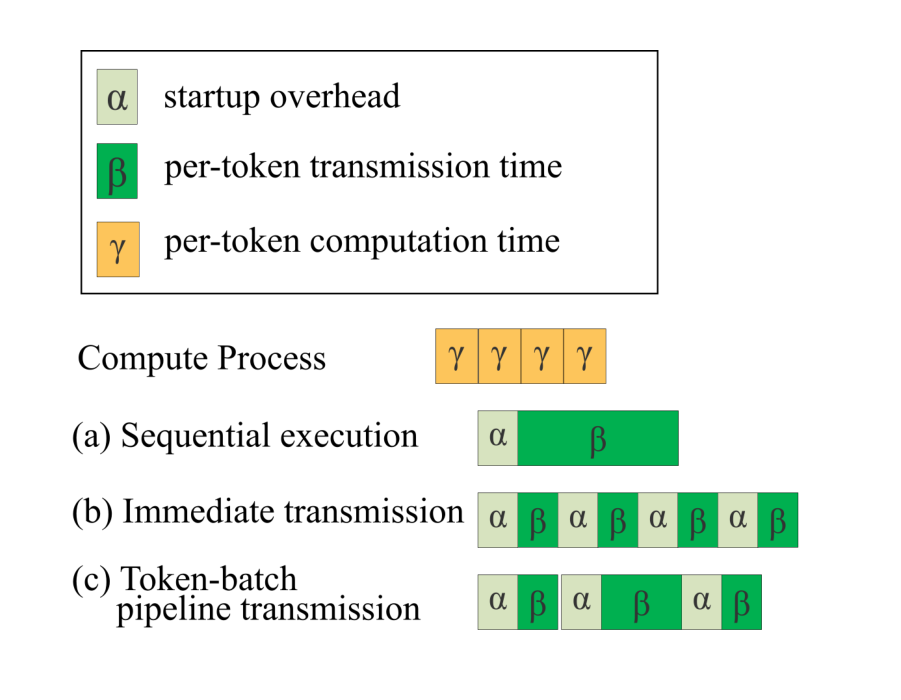
图1|PipeSD 关注的核心系统问题:如何把边缘端 token 生成与云边通信重叠起来,避免“生成完再传”的顺序瓶颈。
PipeSD:把推测解码变成云边流水线
PipeSD 的第一个关键设计是 token-batch pipeline scheduling,即 token 批次流水线调度。直观地说,边缘设备不再等到一整段草稿 token 全部生成后才传输,而是在生成过程中将 token 按合适的批次发送到云端,使通信和本地生成尽可能重叠。
但这里不能简单地“每生成一个 token 就立刻发送”。因为云边通信存在启动开销:如果每个 token 单独传输,会频繁支付通信启动成本,反而可能拖慢系统。因此,PipeSD 将问题建模为一个批次划分问题:哪些 token 应该合并成一批,哪些应该尽早发送,才能在计算时间、传输时间和启动开销之间取得最优平衡。
为此,PipeSD 使用动态规划算法求解最优 token 分批策略。该算法根据边缘端生成速度、通信启动开销和单位 token 传输时间,决定当前调度窗口内的最佳批次边界。由于调度窗口通常较小,动态规划带来的额外开销很低,却可以显著提升计算与通信的重叠效率。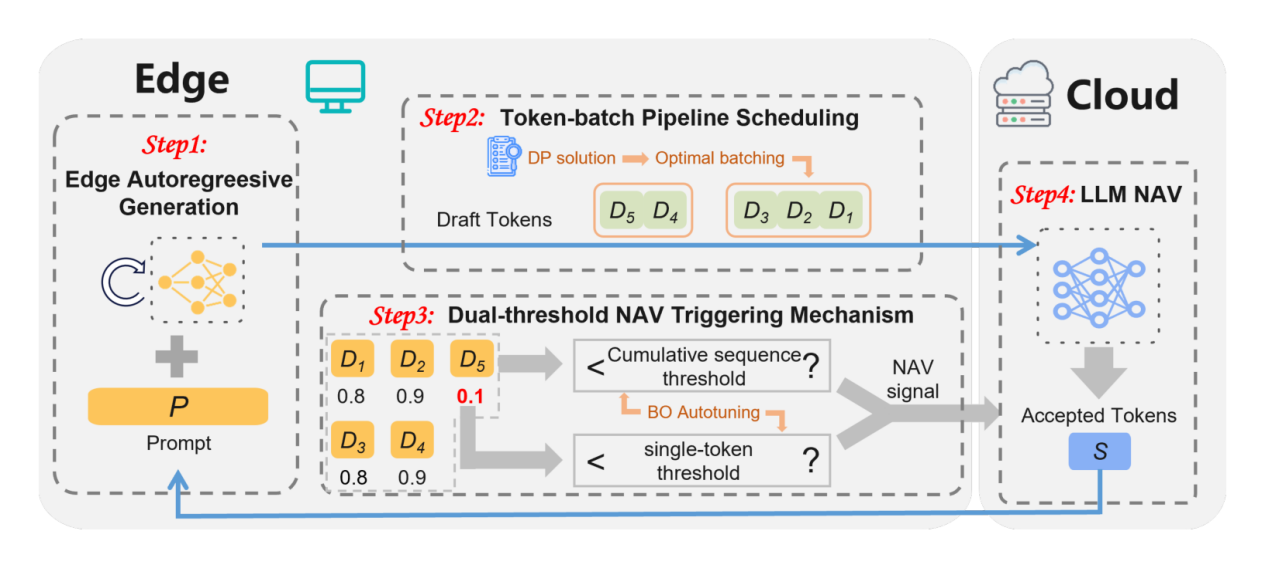
图2|PipeSD 在一个推测轮次中的整体流程:边缘端生成草稿 token,同时进行批次调度和置信度判断;云端在合适时机执行目标模型验证。
双阈值验证:什么时候该让云端出手?
PipeSD 的第二个关键设计是 dual-threshold NAV triggering,即双阈值非自回归验证触发机制。传统方法往往只看单个 token 的置信度,或只看整段序列的累计置信度;这两种单一信号都有局限。
如果只看单 token 置信度,系统可能在某个 token 略低时过早触发验证,错过继续推测的机会;如果只看序列累计置信度,某些低置信度 token 又可能被整体序列信号“掩盖”,导致错误发现过晚,产生更大回滚。
PipeSD 同时考虑两类信号:单个 token 的置信度和整段草稿序列的累计置信度。只有当局部风险或整体风险达到阈值时,系统才触发云端验证。进一步地,PipeSD 引入轻量级贝叶斯优化自动调参器,根据实际运行环境自动寻找合适阈值,使系统能够适应不同网络、设备和任务条件。
真实云边测试床:最高 2.16× 加速,能耗降低 25.3%
论文在真实云边协同测试床上进行了系统评估。边缘端使用配备 Intel Core Ultra 9 185H CPU 的 Lenovo ThinkBook,云端服务器部署在天翼云并配备 NVIDIA A800 GPU。实验覆盖编程任务 HumanEval 和数学推理任务 GSM8K,并设置了四种场景,包括不同边缘算力条件和动态带宽环境。
结果显示,PipeSD 在所有场景下均优于 Vanilla、HSL 和 EdgeLLM 等基线方法。在平均每个接受 token 的生成时间(TPT)上,PipeSD 相比 Vanilla 获得 1.33×–2.16× 加速;相比 HSL 获得 1.19×–1.61× 加速;相比 EdgeLLM 获得 1.16×–1.32× 加速。
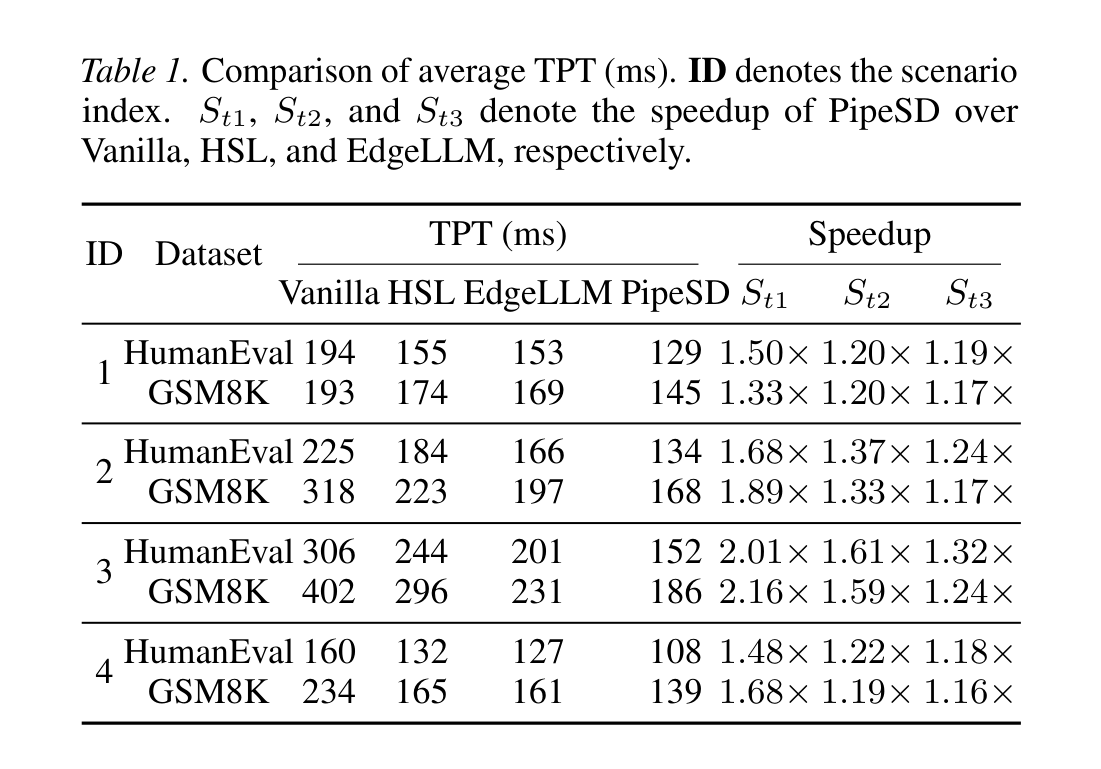
图3|平均 TPT 对比:PipeSD 在 HumanEval 与 GSM8K、不同边缘算力和动态带宽场景中均取得稳定加速。
除了速度提升,PipeSD 还显著降低了云端能耗。论文通过 NVIDIA SMI 对云端 GPU 功耗进行采样,计算每 100 个接受 token 的平均能耗(ECS)。在 Scenario 1 中,PipeSD 相比不同基线最高可降低 25.3% 的云端能耗。这一结果表明,更高效的云边协同不仅能提升用户体验,也有助于降低大模型服务的运行成本。
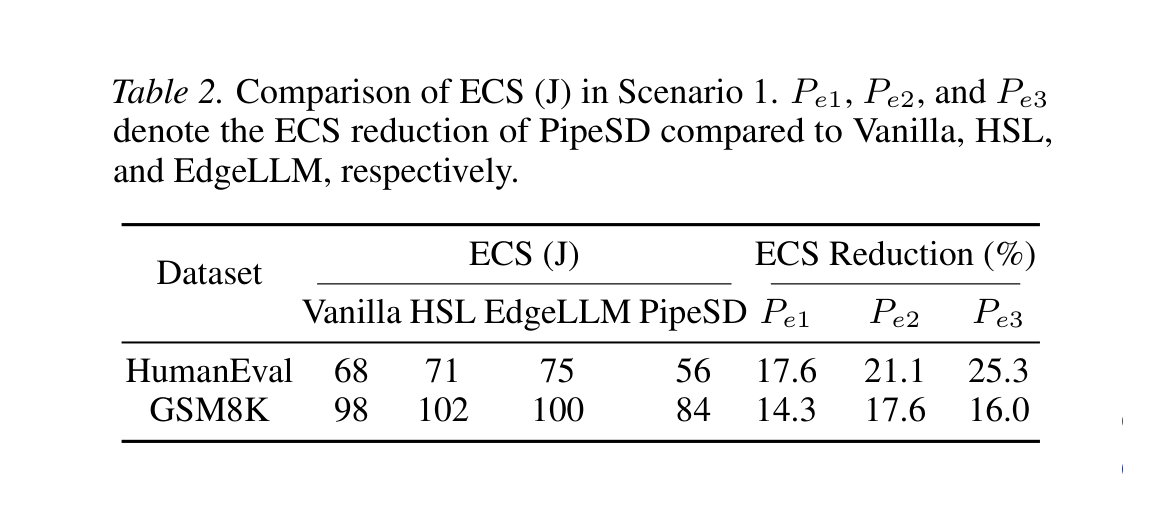
图4|云端能耗对比:PipeSD 在 HumanEval 和 GSM8K 上均降低每 100 个接受 token 的云端能耗。
消融实验:流水线调度与双阈值触发缺一不可
为了验证各个模块的贡献,论文进一步进行了消融实验。结果显示,仅加入流水线调度,或仅调整 NAV 触发方式,都能带来一定提升;但完整的 PipeSD 同时结合 token-batch pipeline scheduling 和 dual-threshold NAV triggering,取得了最好的整体表现。
这说明 PipeSD 的优势不是来自单一技巧,而是来自系统层面的协同设计:通信调度解决“资源如何并行利用”的问题,双阈值验证解决“什么时候该让云端介入”的问题,贝叶斯优化则帮助系统在不同环境下自动适配参数。
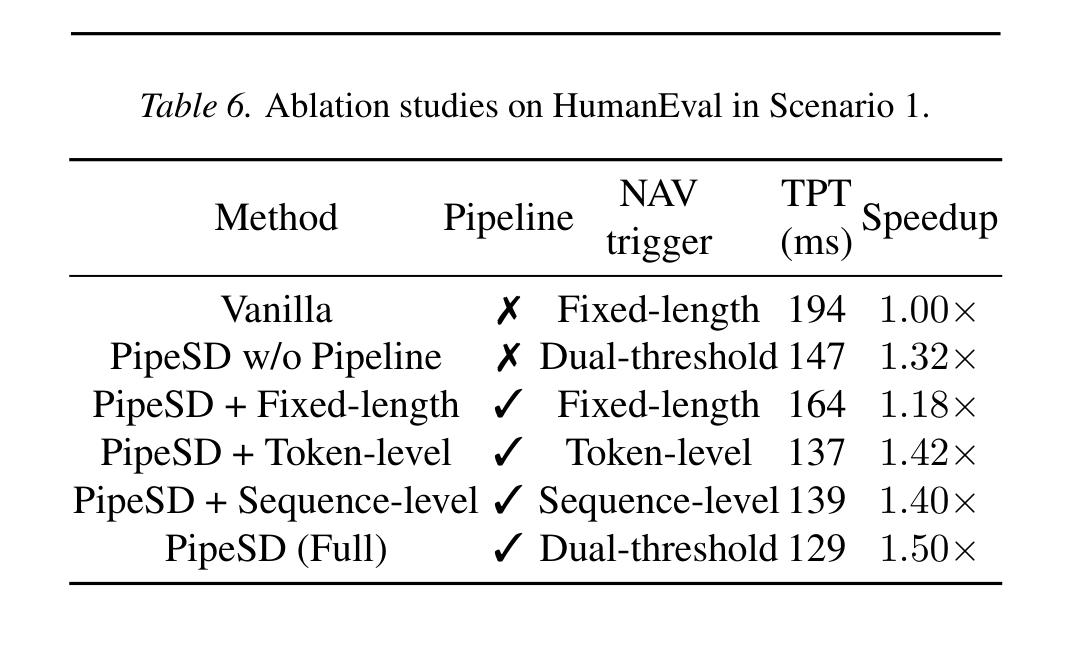
图5|消融实验表明,完整 PipeSD 相比移除流水线、固定长度验证或单阈值验证的变体具有更优性能。
从模型压缩到系统协同:高效 AI 的另一条路径
PipeSD 的研究意义不止于某一个推理框架。随着大模型走向移动端、边缘端和智能体应用,推理系统将越来越需要在云、边、端之间动态分工。未来的大模型服务不一定总是“把所有请求送到云端大 GPU”,而可能是由端侧小模型、边缘设备、云端大模型共同组成的协作系统。
在这样的系统中,关键问题不只是模型本身有多大、多强,也包括:哪些计算应该在本地完成,哪些请求应该发送到云端,通信与计算如何重叠,云端验证何时触发,以及系统如何在带宽波动和设备能力变化下保持稳定性能。PipeSD 正是在这一方向上的一次系统化探索。
对于面向智能终端、移动 Agent、隐私敏感推理和低能耗大模型服务的应用场景,PipeSD 提供了一个重要启示:高效 AI 不只来自模型层面的压缩和量化,也来自云边协同架构、推理流水线和自适应调度策略的共同优化。
持续探索高效、可靠、可部署的大模型系统
北京中关村学院人工智能核心方向团队长期关注大模型系统、智能体、推理优化、云边协同和真实环境部署等前沿方向。PipeSD 是团队在“高效可部署大模型系统”方向上的重要研究成果之一。未来,团队将继续围绕大模型推理加速、云边端协同、Agent 系统执行效率、低能耗 AI 服务和真实环境自适应部署展开研究,推动大模型从实验室能力走向更高效、更可靠、更普惠的实际应用。
团队信息
本文第一作者为北京中关村学院×浙江大学博士生韩云河,相关研究在北京中关村学院人工智能核心部段易通研究员的指导下完成。该研究依托北京中关村学院自由探索项目“高效Agent推理”开展,研究团队长期深耕人工智能系统领域,重点围绕大模型推理加速与智能体系统性能优化开展深入研究。